Nur KI gegen Hybrid: der direkte Vergleich
Ausgangslage
In jedem Büro – ob Verwaltung, Kundenservice oder Sachbearbeitung im Unternehmen – kommen täglich Eingänge an: Anträge, Meldungen, Reklamationen, Rückfragen. Ein großer Teil davon ist gleichförmig. Wer schreibt, worum geht es, wohin gehört der Vorgang, welche Frist gilt.
Die naheliegende Idee ist, jeden Eingang einem Sprachmodell zu geben. Das funktioniert, hat aber drei Nachteile: Jeder Vorgang kostet Rechenzeit und Geld, die Antwortzeit steigt, und eine Entscheidung des Modells lässt sich im Nachhinein schwer begründen. Gerade in der Verwaltung zählt aber die Nachvollziehbarkeit.
Der Ansatz
Das hybride System dreht die Reihenfolge um. Was sich mit festen, prüfbaren Regeln entscheiden lässt, entscheiden Regeln. Die KI kommt nur zum Zug, wenn die Regeln keine eindeutige Antwort finden, und auch dann mit begrenztem Aufwand. Ist die Lage danach immer noch unklar, entscheidet ein Mensch.
- Stufe 1: RegelEindeutiges regelt der CodeFeste, protokollierte Prüfungen. Gleicher Eingang, gleiches Ergebnis.
- Stufe 2: KIMehrdeutiges klärt die KINur für den offenen Rest, mit Budget. Jedes KI-Ergebnis muss dieselben Prüfungen bestehen.
- Stufe 3: MenschUnklares entscheidet ein MenschDas System macht einen Vorschlag; die Benachrichtigung wartet, bis entschieden ist.
Zwei Bausteine kommen hinzu, die das System über die Zeit besser machen: Es erkennt im laufenden Betrieb selbst, wo eine Entscheidung nicht zu den Belegen im Dokument passt, und es lernt aus gelösten Fällen neue Regeln.
Ergebnisse im Vergleich
Gemessen wurde auf 2.000 Vorgängen je Variante, die das System vorher nie gesehen hatte. Beide Varianten bekamen exakt dieselben Eingänge.
| Kennzahl | nur KI | Hybrid |
|---|---|---|
| ohne KI erledigt | 0 % | 82,8 % |
| Tokens je Vorgang | 1.495 | 253 |
| Bearbeitungszeit (Mittel) | 1.098 ms | 213 ms |
| automatisiert, aber falsch | 7 | 5 |
| davon unentdeckt | 1 | 0 |
| Entscheidung durch einen Menschen | 1,9 % | 2,0 % |
Das Ergebnis ist klar: Bei gleicher Qualität braucht das hybride System ein Sechstel des Rechenaufwands und ist rund fünfmal schneller. Die Fehlerzahlen beider Varianten liegen so niedrig, dass der Unterschied statistisch nicht belastbar ist. Wir behaupten deshalb nicht, das System mache weniger Fehler – nur, dass es nicht mehr Fehler macht.
Qualität im laufenden Betrieb
Im Testlabor kennt man die richtige Antwort. Im Betrieb nicht. Die entscheidende Frage für jede Organisation lautet daher: Woran erkennt das System, dass es sich geirrt hat?
Wir sprechen dabei von Abweichungen. Eine Abweichung liegt vor, wenn die Entscheidung nicht zu dem passt, was nachweisbar im Dokument steht. Ein Beispiel: Der Vorgang wird anonym angelegt, obwohl der Name des Absenders im Text steht. Oder ein Name wird mit einem Schreibfehler übernommen, obwohl die Person eindeutig im Stammdatenbestand ist. Eine Prüfung meldet nur, wenn sie den Beleg zitieren kann.
Jede Abweichung landet bei einem Menschen. Der Vorgang wird nicht still abgeschlossen; die Benachrichtigung an die Absenderin oder den Absender wird zurückgehalten, bis entschieden ist. Das System liefert einen Korrekturvorschlag aus dem Beleg, die Sachbearbeitung bestätigt oder korrigiert. Beides wird gezählt: So wird im Betrieb messbar, wie oft die Prüfung recht hat.
Das System lernt seine Regeln selbst
Der wichtigste Unterschied zu einem starren Regelwerk: Das System schreibt seine Regeln nicht nur ab, es leitet sie aus der eigenen Arbeit ab. Zwei Quellen liefern das Material.
- Gelöste KI-Fälle. Hat die KI mehrfach denselben Fall gleich entschieden – etwa eine bestimmte Kurzschreibweise einer Straße oder ein Alltagswort für ein bekanntes Anliegen –, schlägt das System daraus eine feste Regel vor.
- Menschliche Klärungen. Entscheidet die Sachbearbeitung wiederholt auf dieselbe Weise, wird auch daraus ein Regelvorschlag.
Vier Hürden stehen zwischen einem Muster und einer aktiven Regel:
- Hürde 1Genug FälleMindestens 10 gleichartige Vorgänge.
- Hürde 2EindeutigMindestens 90 % der Fälle wurden gleich entschieden.
- Hürde 3PrüfstandNeue, ungesehene Vorgänge laufen ohne und mit Regel. Kein Vorgang darf schlechter werden, und die Regel muss messbar nützen, ohne Mehrkosten.
- Hürde 4FreigabeEin Mensch gibt die Regel frei. Ohne bestandenen Prüfstand ist das technisch gesperrt.
Wirkung der gelernten Regeln
| 2.000 ungesehene Vorgänge | vor dem Lernen | mit 8 gelernten Regeln |
|---|---|---|
| ohne KI erledigt | 82,2 % | 91,5 % |
| Tokens je Vorgang | 265 | 126 |
| Fehler | 3 | 3 |
| Anwendungen der neuen Regeln | – | 277, davon 0 fehlerhaft |
Warum der Prüfstand Pflicht ist
Die erste Regel, die das System aus menschlichen Klärungen gelernt hat, ordnete eingescannte Schreiben über den Namen dem richtigen Absender zu. Sie erledigte mehr Fälle ohne KI, machte aber sechs neue Fehler: Sie übernahm den Namen mit dem Lesefehler aus dem Scan, statt der korrekten Schreibweise aus dem Stammdatenbestand. Keiner dieser Fehler fiel auf.
Wir haben die Regel zurückgezogen und daraus drei Konsequenzen gezogen: Die Regel übernimmt seither den Namen aus dem Stammdatenbestand, die Abweichungsprüfung vergleicht Namen gegen den Bestand, und keine Regel wird mehr ohne Prüfstand freigegeben. Die korrigierte Regel hat den Prüfstand auf 2.000 neuen Vorgängen bestanden: Die Fehlerzahl sank dort von 9 auf 0, kein Vorgang wurde schlechter.
Laborbeweis: neue, nie gesehene Muster
Die bisherigen Lernergebnisse beruhen auf Mustern, die im Datenbestand von Anfang an vorkamen. Für den Betrieb zählt aber, was passiert, wenn plötzlich neue Formulierungen auftauchen – und ob das System dann die richtige Regel lernt oder eine bequeme falsche.
Dazu haben wir drei Fallklassen eingeschleust, die das System nie gesehen hatte:
- Neue Schreibweisen bekannter Ortsangaben, die vom amtlichen Namen abweichen.
- Neue Umschreibungen für bekannte Anliegen: Alltagswörter statt Fachbegriffe.
- Eine Falle. Eingänge mit demselben auffälligen Stichwort, die in rund 91 % der Fälle ein bestimmtes Anliegen meinen, in rund 9 % aber ein ganz anderes. Eine Regel „Stichwort → häufigstes Anliegen“ sähe in den Daten fast perfekt aus und wäre trotzdem falsch.
Was das System gelernt hat
Aus 2.000 Trainingsvorgängen hat das System 11 neue Regeln vorgeschlagen. Alle sind fachlich richtig: die drei neuen Schreibweisen, die neuen Umschreibungen und für die Falle nicht das grobe Stichwort, sondern die genaueren Formulierungen, die das Anliegen tatsächlich eindeutig machen. Kandidaten mit uneinheitlicher Bedeutung (40 bis 66 % Übereinstimmung) hat die 90-%-Hürde verworfen. Alle 11 Regeln haben den Prüfstand bestanden, eine hat dabei einen vorhandenen Fehler behoben.
Wirkung auf 2.000 frischen Vorgängen mit neuen Mustern
Hält der Prüfstand eine falsche Regel auf?
Weil das System die Falle von selbst umgangen hat, haben wir die falsche Regel absichtlich von Hand eingereicht – so, als hätte sie jemand vorgeschlagen. Dann lief sie zweimal über den Prüfstand, jeweils mit 600 neuen Vorgängen.
| Lage | Ergebnis | Prüfstand |
|---|---|---|
| Die genauere, richtige Regel fehlt | Ein Straßenschaden wäre als Müllablagerung weitergegeben worden. Der Prüfstand findet diesen Vorgang. | abgelehnt |
| Die genauere Regel ist aktiv | Beide Regeln widersprechen sich, der Fall geht an die KI. Kein Fehler, aber +5 % Rechenaufwand und kein Nutzen. | bestanden |
Im ersten Fall hat der Prüfstand getan, wofür er da ist, und die anschließende Freigabe von Hand war technisch gesperrt. Der zweite Fall zeigt eine Lücke: Der Prüfstand bewertete nur Fehler, keine Kosten. Wir haben ihn deshalb verschärft: Eine Regel besteht nur noch, wenn sie in den Vorgängen, in denen sie greift, messbar nützt (mehr Vorgänge ohne KI oder behobene Fehler) und dort keine Mehrkosten verursacht.
Nachtest des verschärften Prüfstands auf erneut frischen 600 Vorgängen je Regel:
| Regel | Wo sie griff | Prüfstand |
|---|---|---|
| Falsche Stichwort-Regel (Falle) | 43 Vorgänge, kein einziger mehr ohne KI, kein Fehler behoben | abgelehnt |
| Gelernte Schreibweise einer Ortsangabe | 16 Vorgänge, alle 16 jetzt ohne KI statt mit KI | bestanden |
| Gelernte Formulierung, die eine allgemeinere Regel schon abdeckt | 8 Vorgänge, kein Unterschied | abgelehnt |
Damit fängt der Prüfstand jetzt beides ab: Regeln, die schaden, und Regeln, die nichts bringen. Überflüssige Regeln sind kein Fehler, aber sie machen das Regelwerk größer, ohne es besser zu machen – auch das war eine Lehre aus den Lernexperimenten: klein anfangen, Größe nur, wo sie messbar nützt.
Woher die Methodik kommt
Die Prüfregeln dieses Systems sind nicht am Schreibtisch entstanden. Sie gehen auf eigene Lernexperimente in künstlichen Welten zurück: Figuren, die in einer Physiksimulation stehen und aufstehen lernen, und eine digitale Petrischale, in der Lebewesen mit kleinen Gehirnen über viele Generationen Verhalten entwickeln. Dort lässt sich gut beobachten, woran Lernen scheitert. Die Lehren daraus haben wir auf die Prozess-KI übertragen.
Die Petrischale: 1.843 Lebewesen, 24 Futterquellen
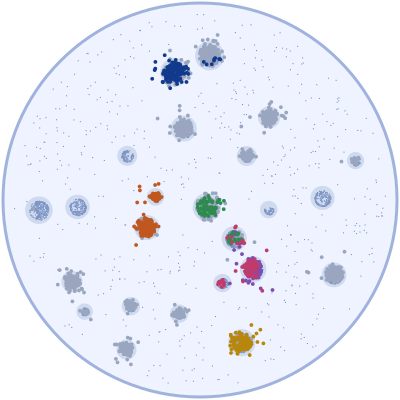
Riechen können die Lebewesen von Anfang an, und angeboren ist nur ein einfacher Reflex: hungrig zur stärker duftenden Seite drehen. Dem Duft gezielt zu folgen, hat ihr Gehirn selbst gelernt – nicht im einzelnen Leben, sondern über rund 76 Generationen. Gemessen wird ohne den Reflex: Riecht es rechts stärker, dreht das Gehirn selbst nach rechts?
| Beobachtung in den Lernexperimenten | Umsetzung im hybriden System |
|---|---|
| Die Bewertung formt das Verhalten stärker als das Gehirn. Fast jedes unerwartete Verhalten ging auf eine Bewertung mit Schlupfloch zurück. | Die kritische Kennzahl ist „automatisiert, aber falsch“. Automatisierung und Genauigkeit stehen immer nebeneinander, damit „alles an den Menschen geben“ nicht gut aussieht. |
| Ein Glückstreffer ist kein Können. Erst die wiederholte Prüfung in neuen Situationen trennt Fähigkeit von Zufall. | Lernen und Prüfen sind strikt getrennt. Bewiesen wird nur auf Daten, die nie zuvor benutzt wurden. Eine Regel braucht mindestens 10 Fälle und 90 % Übereinstimmung. |
| Verhalten lässt sich an Paaren von Testsituationen messen. | Der Prüfstand bearbeitet jeden Vorgang einmal ohne und einmal mit der neuen Regel. |
| Neues verdrängt Altes, wenn das Alte nicht geübt wird. | Alle früheren Prüffälle laufen bei jeder Änderung mit. Kein Vorgang darf schlechter werden. |
| Was die Umgebung schon erzwingt, muss nicht gelernt werden – und wird zuverlässiger eingehalten. | Feste Prüfungen sind fest eingebaut: Jeder Wert der KI muss im Dokument belegt sein, bestimmte Entscheidungen sind ohne Anlass gar nicht wählbar. |
| Größere Netze lernten nicht besser, die kleinsten waren am schnellsten. | Kleine, eindeutige Regeln zuerst. Die KI nur für den Rest und mit begrenztem Aufwand je Vorgang. |
| Startbedingungen verzerren das Ergebnis, einzelne Läufe reichen für Aussagen nicht. | Jede Aussage steht auf mehreren frischen Prüfsätzen. Absichtlich eingeschleuste Testfehler werden nicht den Regeln angelastet. |
| Nachvollziehbar bleibt nur, was mitgeschrieben wird. | Jede Regel hat Herkunft, Treffer, Fehler und Prüfstand-Ergebnis. Bei jeder menschlichen Entscheidung bleibt der Vorschlag des Systems erhalten. |
Der Fallen-Test hat die erste dieser Lehren noch einmal bestätigt: Der Prüfstand selbst hatte ein Schlupfloch, weil er nur Fehler bewertete und keine Kosten. Die Bewertung zuerst an Gegenbeispielen zu prüfen, gilt auch für das Prüfwerkzeug.
Grenzen der Untersuchung
- Alle Vorgänge sind synthetisch und stammen aus einem eigenen, reproduzierbaren Testgenerator. Die Werte gelten für diese Daten; echte Eingänge sind vielfältiger.
- Als Referenz dient eine simulierte Sachbearbeitung, die immer richtig entscheidet. Im Betrieb irren auch Menschen.
- Die neuen Muster und die Falle haben wir selbst entworfen. Der Laborbeweis zeigt, dass der Mechanismus greift, nicht, wie häufig und wie tückisch neue Muster im Alltag sind.
- Die Fehlerzahlen sind so klein, dass Unterschiede zwischen den Varianten statistisch nicht belastbar sind.
Der nächste Schritt ist ein Pilot mit echten, anonymisierten Eingängen.
Fazit
Ein Büro muss nicht jeden Eingang einer KI geben, um von KI zu profitieren. Wer das Eindeutige mit Regeln erledigt, die KI für den mehrdeutigen Rest einsetzt und bei unklarer Lage einen Menschen entscheiden lässt, spart rund fünf Sechstel des Rechenaufwands bei gleicher Qualität. Das System wird im Betrieb besser, weil es aus der eigenen Arbeit Regeln lernt – und es bleibt verlässlich, weil jede neue Regel erst auf ungesehenen Fällen beweisen muss, dass sie nichts verschlechtert, und ein Mensch sie freigibt.
Methodik, Daten und Testgenerator sind auf Anfrage verfügbar: patrick@zajonc.info
Messbasis: mehr als 16.000 synthetische Vorgänge aus Büro- und Verwaltungsarbeit (Anträge, Meldungen, Reklamationen), jeder Prüflauf auf zuvor nie verwendeten Daten. Vertrauensbereiche nach Clopper-Pearson (95 %). Stand: 13. November 2026.